 Lê Tuấn Việt
Perplexity AI là gì và cách nghiên cứu dữ liệu
Perplexity AI là cỗ máy trả lời (answer engine) kết hợp tìm kiếm web thời gian thực với mô hình ngôn ngữ lớn để tổng hợp đáp án trực tiếp kèm trích dẫn nguồn, giải đáp câu hỏi Perplexity AI là gì trong tra cứu dữ liệu. Khi đưa công cụ vào vận hành, nhiều đội ngũ chỉ đặt câu hỏi nhanh như khung trò chuyện mà bỏ qua bước khóa phạm vi nguồn và kiểm tra dữ liệu gốc. Nếu nhân sự chép nguyên số liệu máy tóm tắt mà không mở liên kết đính kèm để đối chiếu ngữ cảnh, doanh nghiệp rất dễ đưa con số lệch phạm vi vào kế hoạch kinh doanh. Tôi là Lê Tuấn Việt, Marketing Leader tại TAKI Group. Trong bài viết này, tôi làm rõ ranh giới phân công với Google Search và ChatGPT, quy trình tra cứu có người kiểm duyệt cùng tiêu chí chọn gói bảo mật cho đội ngũ.
 Lê Tuấn Việt Marketing Leader tại TAKI Group
- Đăng ngày
- Cập nhật

Tóm tắt nhanh
- Perplexity AI là cỗ máy trả lời theo thời gian thực dùng cơ chế tạo sinh tăng cường truy xuất (RAG) để tóm tắt thông tin từ web kèm số thứ tự trích dẫn gốc, giúp rút ngắn thời gian gom dữ liệu ban đầu chứ không thay thế bước đọc kiểm chứng của con người.
- Phân công đúng vai trò giúp đội ngũ không dùng sai công cụ: Google Search dùng để khảo sát trang kết quả thực tế và truy vấn địa phương, Perplexity AI dùng để gom báo cáo ngành kèm nguồn cấp một, còn ChatGPT dùng để biên tập cấu trúc hoặc chuyển đổi định dạng nội dung.
- Quy trình nghiên cứu thị trường an toàn với Perplexity gồm bốn bước: chuẩn hóa câu lệnh kèm chế độ Focus, tải tài liệu đã ẩn danh vào Spaces để đối chiếu, lập bản đồ thực thể nội dung và mở từng liên kết trích dẫn để xác thực trước khi duyệt.
- Với đội marketing từ 3 đến 5 người chỉ tra cứu dữ liệu công khai, gói Perplexity Pro (20 USD mỗi tháng theo biểu phí năm 2025) là đủ dùng; khi bắt buộc tải báo cáo nội bộ lên hệ thống, doanh nghiệp cần nâng lên gói Enterprise Pro (từ 40 USD mỗi người mỗi tháng) để được cam kết mặc định không dùng dữ liệu huấn luyện mô hình.
Mục lục bài viết8 phần
Perplexity AI là gì và cơ chế trả lời kèm nguồn
Perplexity AI là một cỗ máy trả lời (answer engine) ra mắt năm 2022, kết hợp tìm kiếm web theo thời gian thực với các LLM (Large Language Model, mô hình ngôn ngữ lớn) để tổng hợp câu trả lời trực tiếp kèm trích dẫn nguồn đánh số tại chỗ. Thay vì trả về danh sách liên kết để người dùng tự đọc từng trang, hệ thống tự động thu thập, đối chiếu và tóm tắt dữ liệu từ các nguồn đang hoạt động.
Trong chuyên mục AI Marketing, việc hiểu đúng Perplexity AI là gì về mặt cấu trúc kỹ thuật giúp đội ngũ phân biệt rõ giữa tốc độ gom thông tin và chất lượng phân tích chiến lược. Ba lớp vận hành cốt lõi tạo nên sự khác biệt của nền tảng này gồm: định vị cỗ máy trả lời trực diện, cơ chế truy xuất thời gian thực kết hợp đa mô hình và hệ sinh thái không gian làm việc mở rộng.
Nguồn gốc Perplexity AI và định vị cỗ máy trả lời
Theo tài liệu của Perplexity AI Help Center cập nhật năm 2025, nền tảng này được thành lập năm 2022 bởi Aravind Srinivas cùng các đồng sáng lập Denis Yarats, Johnny Ho và Andy Konwinski. Ngay từ đầu, nhóm phát triển định vị sản phẩm là một cỗ máy trả lời giải quyết thẳng câu hỏi của người dùng thay vì công cụ tìm kiếm danh sách liên kết truyền thống.
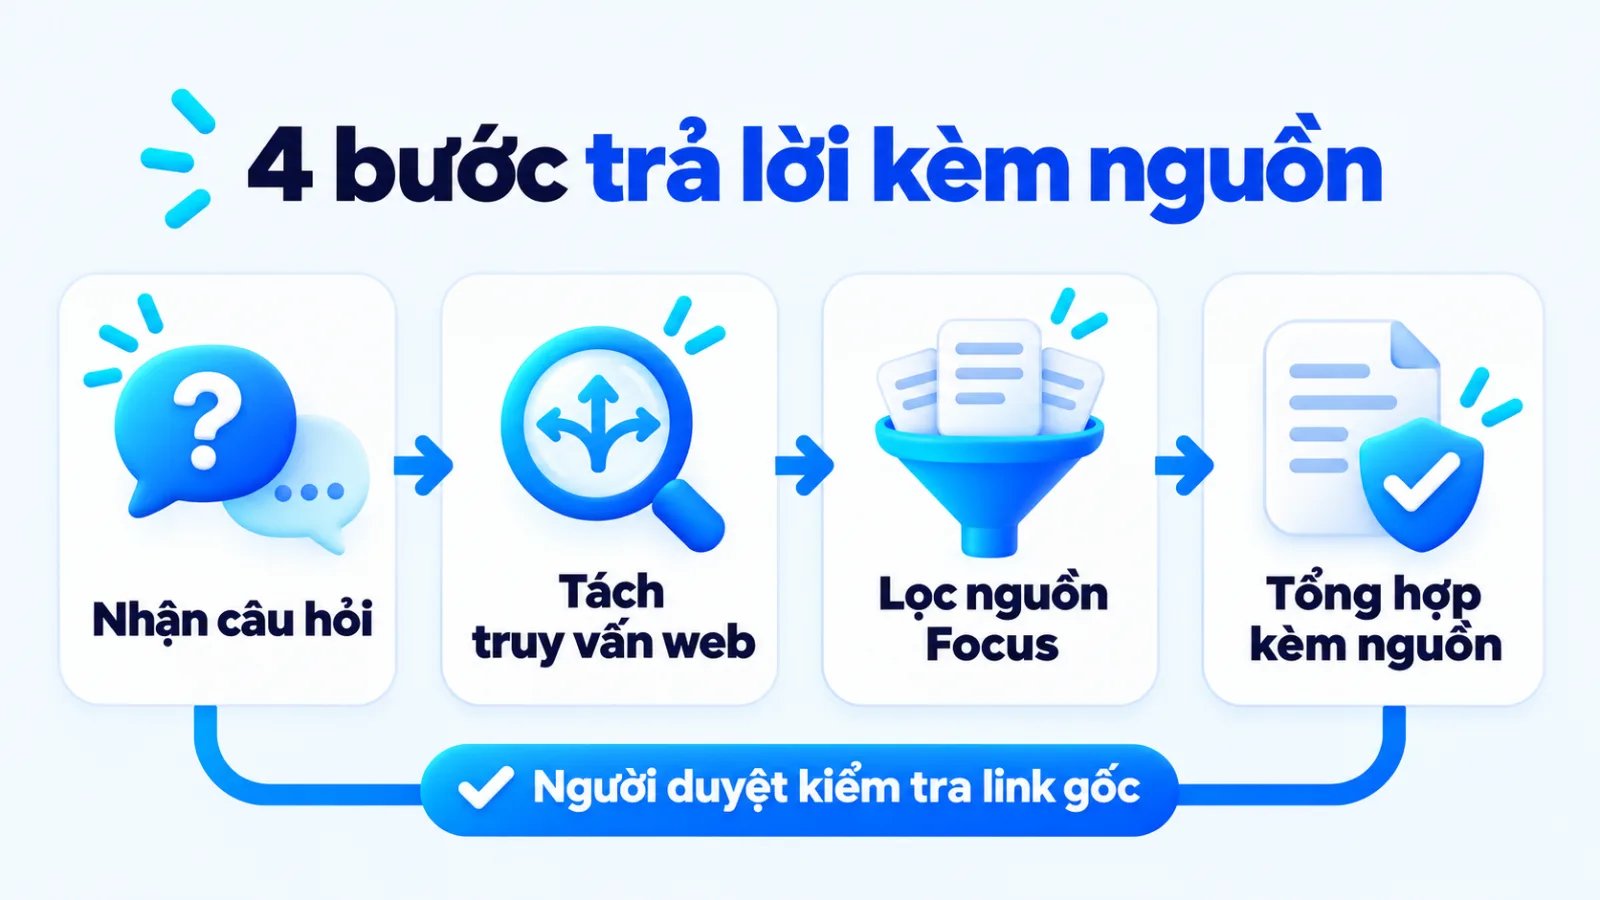
Sự khác biệt nằm ở sản phẩm đầu ra của mỗi lượt truy vấn. Khi người làm marketing cần tra cứu quy định ngành hoặc thông số kỹ thuật, một danh sách mười đường dẫn xanh buộc nhân sự phải mở từng trang, lọc bỏ quảng cáo rồi tự ghi chép lại. Cỗ máy trả lời rút ngắn khâu đọc thô đó bằng cách chắt lọc đoạn văn liên quan nhất và đặt số thứ tự nguồn ngay sau mệnh đề được tổng hợp.
Cơ chế tìm kiếm thời gian thực và Model Council
Về mặt kỹ thuật, hệ thống vận hành dựa trên kiến trúc RAG (Retrieval-Augmented Generation, tạo sinh tăng cường truy xuất). Khi nhận câu hỏi, công cụ tách ý định thành các truy vấn tìm kiếm trên web theo thời gian thực, thu thập văn bản từ các trang đích rồi mới giao cho mô hình ngôn ngữ tóm tắt thành câu trả lời có gắn chỉ mục [1], [2] tương ứng với từng đường dẫn nguồn.
Bên cạnh mô hình nội bộ, người dùng gói trả phí có thể chuyển đổi linh hoạt giữa GPT, Claude và Gemini tùy theo tác vụ phân tích. Đặc biệt, theo công bố trên Perplexity AI Hub năm 2025, tính năng Model Council (Hội đồng mô hình) cho phép truy vấn song song từ 2 đến 8 mô hình cùng lúc để đối chiếu điểm đồng thuận và phát hiện góc nhìn khác biệt trên một câu hỏi nghiên cứu.
Chế độ lọc nguồn Focus, Spaces và hệ sinh thái mới
Để tránh tình trạng mô hình lấy thông tin từ các trang tổng hợp kém chất lượng, nền tảng cung cấp chế độ Focus (lọc phạm vi nguồn) ngay tại thanh nhập liệu. Người dùng có thể khóa phạm vi tra cứu vào tài liệu học thuật (Academic), thảo luận mạng xã hội (Social), nội dung video (Video) hoặc tìm kiếm web mở rộng trước khi bấm gửi yêu cầu.
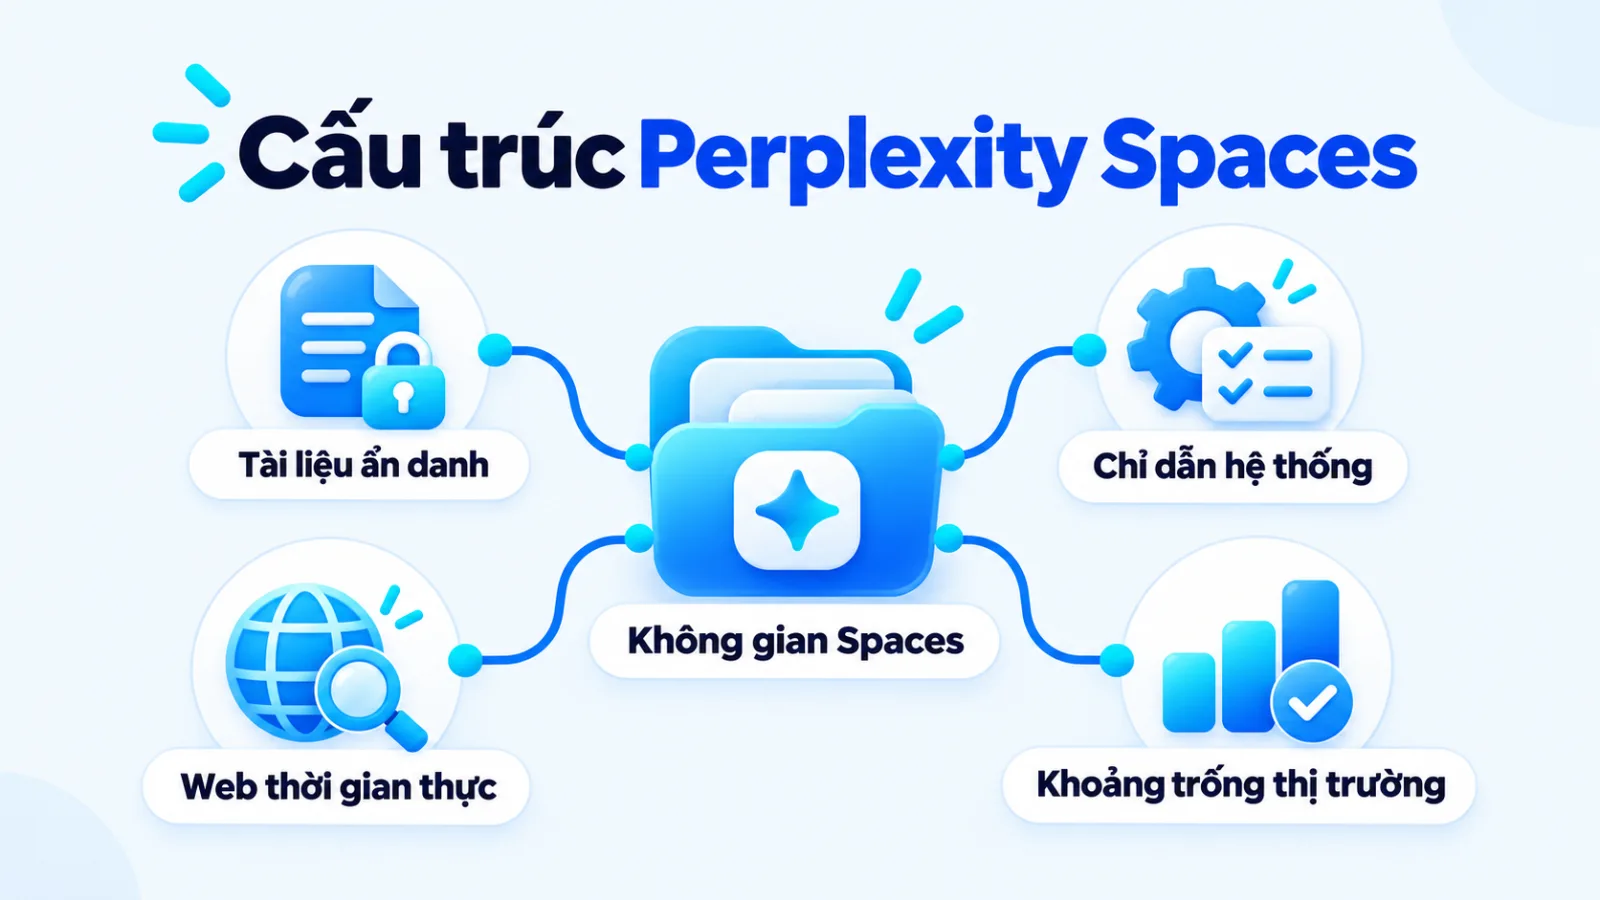
Theo lộ trình sản phẩm trên Perplexity AI Help Center tính đến năm 2025, hệ sinh thái nền tảng đã mở rộng sang bốn công cụ chuyên sâu. Đầu tiên là Perplexity Spaces (ra mắt năm 2024, sau mở rộng thành Projects) cho phép tải tệp nội bộ kèm chỉ dẫn riêng. Tiếp theo là Deep Research (ra mắt tháng 2/2025) tự động chạy hàng chục truy vấn và đọc hàng trăm nguồn để lập báo cáo trong vài phút.
Hai mảnh ghép tiếp theo được Perplexity AI Hub công bố năm 2025 là trình duyệt AI Comet phát triển trên nhân Chromium cùng công cụ tác nhân tự động Perplexity Computer giúp xử lý tác vụ đa bước. Để nắm rõ giới hạn tự chủ của Comet hay Computer trước khi giao việc, bạn có thể đọc thêm bài phân biệt tác nhân AI và chatbot trong vận hành doanh nghiệp.
Perplexity khác Google và ChatGPT ở điểm nào
Câu hỏi Perplexity khác Google và ChatGPT ở điểm nào được trả lời rõ nhất qua kiến trúc xử lý dữ liệu mặc định của từng nền tảng. Trong khi Google Search ưu tiên xếp hạng trang đích và ChatGPT ưu tiên tạo sinh hội thoại từ ngữ cảnh, Perplexity AI đặt bước truy xuất nguồn thời gian thực làm điều kiện bắt buộc trước khi viết câu trả lời theo năm tiêu chí trong bảng so sánh Perplexity dưới đây.
Bảng đối chiếu cơ chế dữ liệu và mục đích sử dụng
Theo Google Search Central năm 2024, công cụ tìm kiếm truyền thống vận hành qua ba bước: thu thập dữ liệu (crawling), lập chỉ mục (indexing) và phân phối kết quả xếp hạng. Ngược lại, theo công bố của OpenAI tháng 10/2024, ChatGPT là mô hình đối thoại tạo sinh trước khi tích hợp thêm tìm kiếm web. Năm tiêu chí dưới đây giúp người phụ trách xác định rõ việc nào giữ ở công cụ tìm kiếm và việc nào chuyển sang cỗ máy trả lời.
| Tiêu chí đối chiếu | Perplexity AI | Google Search và ChatGPT |
|---|---|---|
| Mục đích thiết kế gốc | Cỗ máy trả lời trực tiếp, tổng hợp thông tin đa nguồn và gắn trích dẫn tại chỗ | Google điều hướng tới trang đích xếp hạng; ChatGPT đối thoại tạo sinh và xử lý tác vụ |
| Cơ chế dữ liệu mặc định | Luôn tìm kiếm web thời gian thực trước rồi mới tóm tắt bằng mô hình ngôn ngữ | Google khớp chỉ mục trang web; ChatGPT kết hợp dữ liệu huấn luyện với tìm kiếm khi bật |
| Cách hiển thị nguồn | Gắn số thứ tự [1], [2] ngay sau từng câu hoặc số liệu để bấm sang bài gốc | Google liệt kê danh sách liên kết; ChatGPT gắn nguồn cuối đoạn khi dùng chế độ tìm kiếm |
| Khả năng viết dài | Trung bình, thiên về tóm tắt thông tin cô đọng và lập hồ sơ dữ kiện nghiên cứu | Google không tự viết bài; ChatGPT mạnh về biên tập bài dài và chuyển đổi giọng văn |
| Tác vụ tối ưu nhất | Tra cứu số liệu ngành, kiểm tra chéo nguồn cấp một và lập bản đồ thực thể | Google khảo sát SERP và địa phương; ChatGPT viết nháp, lập trình và lên kịch bản |
Khi đọc bảng đối chiếu trên, người phụ trách cần lưu ý ranh giới tính năng giữa các nền tảng đang thu hẹp dần từ cuối năm 2024 khi Google mở rộng bản tóm tắt AI và ChatGPT tích hợp tìm kiếm web. Tuy nhiên, sự khác biệt về hành vi mặc định vẫn quyết định hiệu suất làm việc: một công cụ sinh ra để tra cứu nguồn sẽ buộc nhân sự nhìn vào bằng chứng trước khi nhìn vào câu chữ diễn đạt.
Khi nào kết hợp cả ba công cụ trong một luồng việc
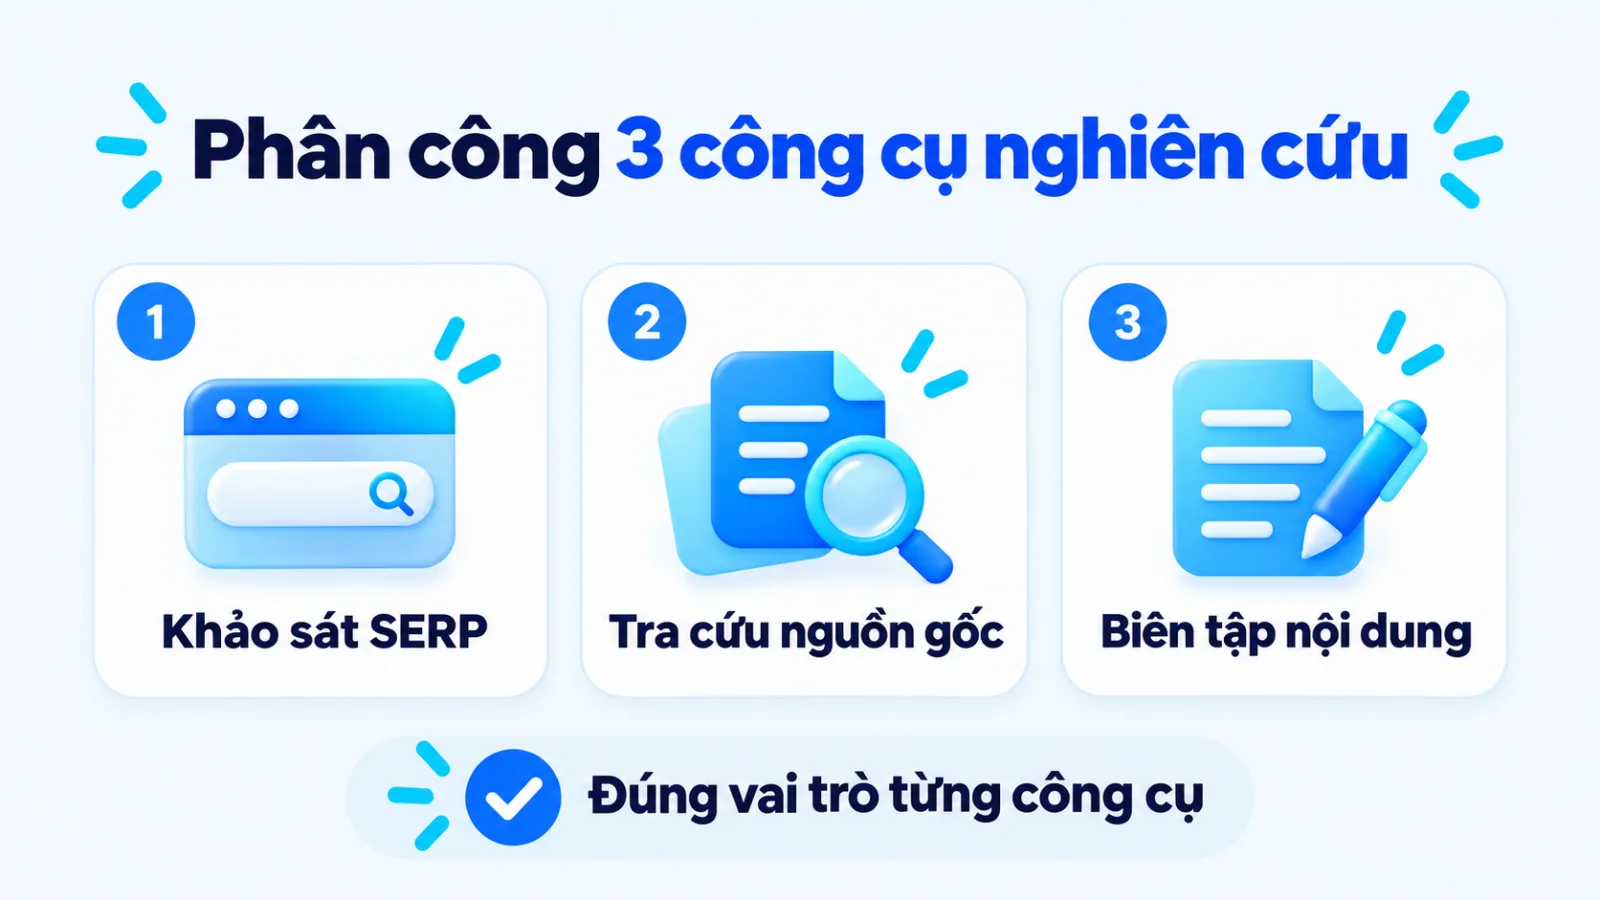
Sai lầm phổ biến của nhiều phòng marketing nhỏ là cố dùng một công cụ đơn lẻ cho toàn bộ chuỗi sản xuất từ nghiên cứu thị trường đến viết bài hoàn chỉnh. Khi giao cho ChatGPT việc tự tìm số liệu mà không khóa nguồn, bài viết dễ rơi vào cảnh câu văn trôi chảy nhưng thiếu căn cứ xác thực. Ngược lại, nếu bắt Perplexity viết bài bán hàng dài, văn phong thu được thường khô cứng như bản điểm tin tổng hợp.
Tôi ưu tiên tách bạch vai trò của từng nền tảng theo đúng điểm mạnh cơ chế trong một luồng công việc nối tiếp nhau. Đầu tiên, nhân sự dùng Google Search để quan sát trực tiếp SERP (Search Engine Results Page, trang kết quả của công cụ tìm kiếm), xem các đối thủ tại Việt Nam đang triển khai định dạng nội dung nào và có những tính năng địa phương gì.
Tiếp theo, nhóm đưa các câu hỏi chuyên sâu vào Perplexity AI để gom báo cáo gốc, thông tư pháp lý và lập danh sách thuộc tính chủ đề. Cuối cùng, dữ liệu đã được con người kiểm chứng mới đưa sang ChatGPT để biên tập thành bài viết, kịch bản hoặc tài liệu phục vụ các luồng cá nhân hóa trải nghiệm bằng AI theo từng nhóm khách hàng.
Cách dùng Perplexity nghiên cứu thị trường cho SME
Khi dùng Perplexity để nghiên cứu thị trường đạt độ tin cậy cao cho SME (Small and Medium Enterprise, doanh nghiệp vừa và nhỏ), đội ngũ không thể chỉ gõ một câu hỏi ngắn rồi chép nguyên văn kết quả. Quy trình cách dùng Perplexity an toàn bắt buộc đi qua bốn bước tuần tự gồm: chuẩn hóa câu lệnh kèm chế độ Focus, đối chiếu tài liệu trong Spaces, lập bản đồ thực thể và kiểm chứng trích dẫn gốc.
- 01Chuẩn hóa câu lệnh và FocusKhóa rõ vai trò, thị trường, mốc thời gian và chọn chế độ lọc nguồn phù hợp
- 02Đối chiếu chéo trong SpacesTải tệp sản phẩm đã ẩn danh lên không gian làm việc để so khớp với dữ liệu web
- 03Lập bản đồ thực thể nội dungTrích xuất các khái niệm, thuộc tính và câu hỏi người mua theo từng giai đoạn
- 04Kiểm chứng liên kết trích dẫnMở trực tiếp đường dẫn [1], [2] để xác nhận con số và phạm vi mẫu trước khi duyệt
Bước 1: Chuẩn hóa câu lệnh và chọn chế độ Focus
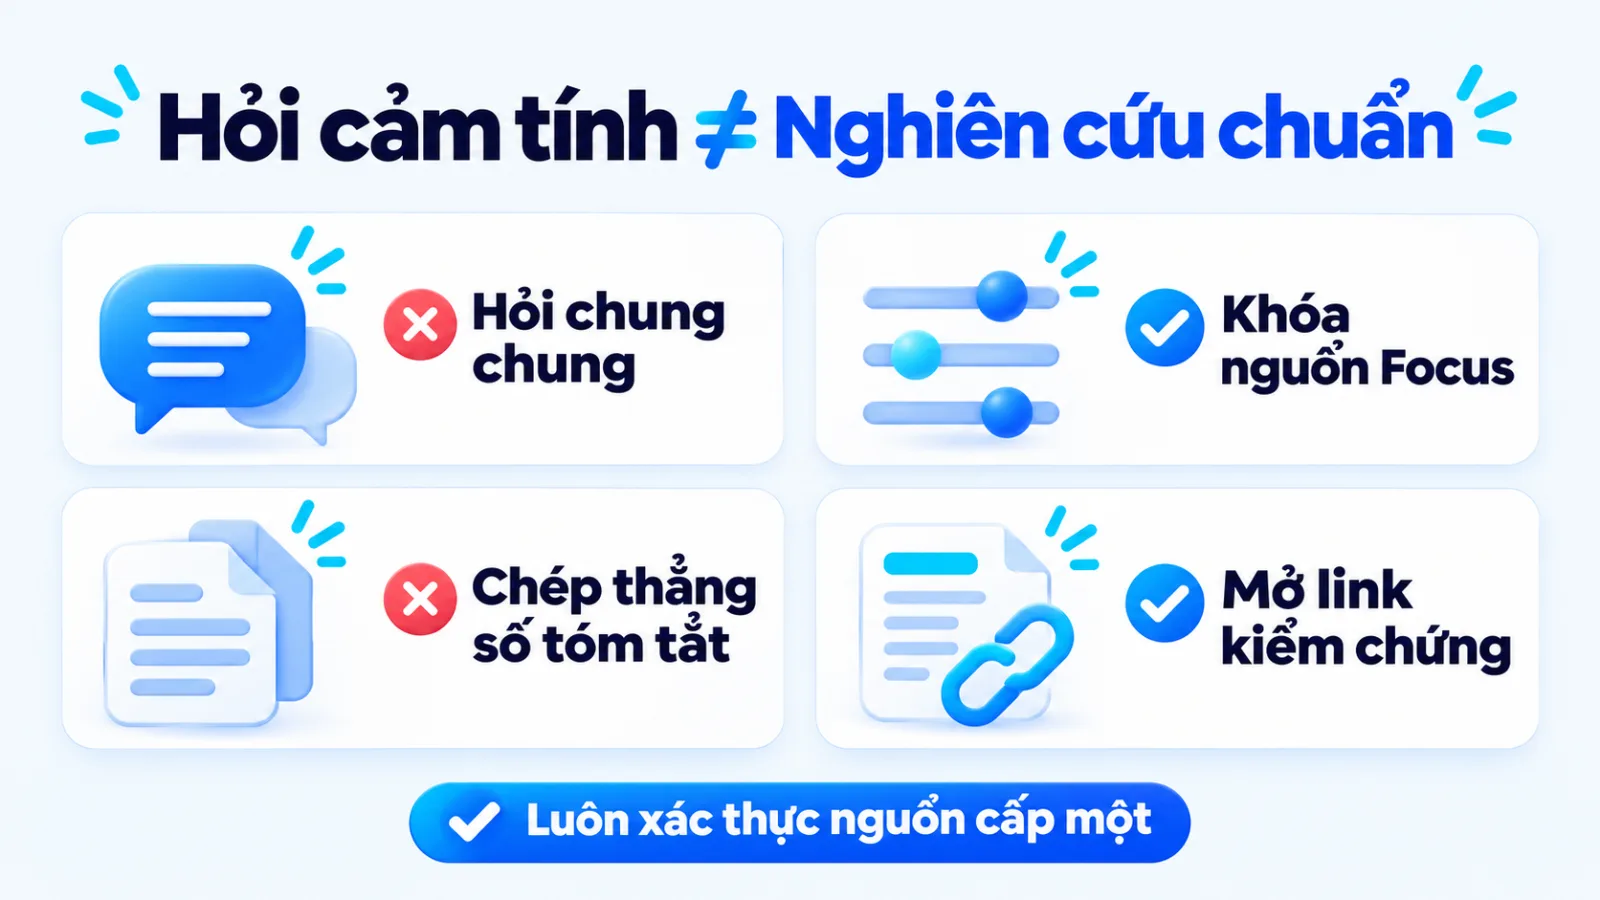
Thao tác đầu tiên là khóa phạm vi truy xuất bằng câu lệnh có đủ bốn thông số gồm chủ đề, địa lý, khoảng thời gian và loại tổ chức phát hành, đồng thời bật chế độ Focus tương ứng. Nếu cần số liệu nghiên cứu khoa học hoặc y tế, bạn chọn chế độ Academic; nếu cần nắm bắt ngôn ngữ tự nhiên và phàn nàn thực tế của người tiêu dùng, bạn chuyển sang chế độ Social hoặc Video.
Thay vì nhập câu lệnh mơ hồ như "Tìm xu hướng mỹ phẩm năm nay", nhân sự nên khóa rõ: "Tổng hợp báo cáo giai đoạn 2024–2025 về hành vi mua kem chống nắng tại Việt Nam, ưu tiên nguồn từ đơn vị nghiên cứu hoặc cơ quan quản lý, ghi rõ cỡ mẫu và phạm vi khảo sát" (ví dụ biên tập, không phải kết quả khách hàng thật). Bước khóa điều kiện này giúp loại bỏ các trang tổng hợp không rõ nguồn gốc.
Đầu ra: Bản tóm tắt sơ bộ kèm danh sách từ 5 đến 10 đường dẫn thuộc đúng nhóm tổ chức phát hành gốc đã chỉ định.
Bước 2: Tải tài liệu vào Spaces để đối chiếu chéo
Sau khi có nhóm nguồn thị trường ban đầu, bạn tạo một không gian làm việc riêng trong Perplexity Spaces (hoặc Projects) và tải lên tài liệu mô tả sản phẩm, bảng câu hỏi thường gặp của bộ phận bán hàng đã được xóa thông tin nhạy cảm. Tại mục chỉ dẫn hệ thống (Custom Instructions), bạn yêu cầu công cụ luôn đối chiếu thông tin tìm được trên web với năng lực cung ứng thực tế trong tệp đính kèm.
Cách kết hợp này giải quyết điểm nghẽn lớn khi lập kế hoạch: nghiên cứu thị trường một đằng nhưng năng lực sản phẩm của công ty một nẻo. Khi đặt tài liệu nội bộ cạnh dữ liệu thời gian thực, công cụ giúp chỉ ra ngay những nhu cầu khách hàng đang tìm kiếm nhiều trên mạng nhưng tài liệu bán hàng hiện tại của doanh nghiệp chưa giải đáp thấu đáo.
Đầu ra: Bảng đối chiếu khoảng trống thông tin giữa nhu cầu thị trường trên web và hồ sơ sản phẩm hiện có của doanh nghiệp.
Bước 3: Lập bản đồ thực thể phục vụ sản xuất nội dung
Ở bước thứ ba, đội ngũ kết hợp chế độ Deep Research hoặc câu lệnh phân rã chủ đề khi dùng Perplexity để sản xuất nội dung theo hướng ngữ nghĩa (Semantic SEO). Bạn yêu cầu hệ thống liệt kê các thực thể liên quan, các thuộc tính kỹ thuật người mua thường cân nhắc và những câu hỏi phản đối trước khi ra quyết định mua hàng.
Tại sao không lấy luôn báo cáo của Deep Research làm bài đăng mà phải tách thành bản đồ thực thể? Văn bản do máy tổng hợp dù dài vẫn chỉ là phần giao thoa của các bài đã có trên mạng, thiếu tiêu chí lựa chọn và điều kiện vận hành riêng của doanh nghiệp. Việc trích xuất khung thực thể rồi đưa vào mẫu kế hoạch marketing giúp đội ngũ giữ trọn góc nhìn chuyên môn.
Đầu ra: Khung bản đồ thực thể, danh sách thuộc tính cần bao phủ và bộ câu hỏi thực tế của người mua theo từng tầng phễu.
Bước 4: Kiểm chứng trích dẫn gốc trước khi duyệt
Bước cuối cùng và bắt buộc là người phụ trách mở trực tiếp từng liên kết đánh số [1], [2], [3] ở các mệnh đề chứa số liệu, mốc pháp lý hoặc kết luận quan trọng để đọc văn bản gốc. Nhân sự kiểm tra xem con số đó nằm ở đoạn nào trong bài gốc, đo vào năm nào, trên mẫu khảo sát bao nhiêu người và có bị cắt bớt điều kiện áp dụng hay không.
Ví dụ biên tập, không phải kết quả khách hàng thật
Đối chiếu nguồn cấp một khi lập hồ sơ nội dung cho phòng khám nha khoa
Trong một ví dụ biên tập, không phải kết quả khách hàng thật, nhóm nội dung phòng khám nha khoa tại Hà Nội dùng Perplexity tra cứu tỷ lệ người lớn gặp vấn đề nha chu. Bản tóm tắt đầu tiên dẫn một trang tin tổng hợp, nhưng khi mở liên kết gốc thì bài viết không nêu năm khảo sát. Người duyệt đã lọc lại nguồn từ cổng thông tin Bộ Y tế để lấy đúng số liệu có kỳ đo rõ ràng trước khi duyệt bài.
Chỉ những dữ kiện vượt qua bước đối chiếu trang đích này mới được phép đi tiếp vào quy trình viết bài hoặc báo cáo kế hoạch. Việc đặt chốt chặn con người ở cuối luồng tra cứu chính là cách vận hành quy trình kiểm duyệt human-in-the-loop giúp bảo vệ uy tín thương hiệu trước các lỗi tổng hợp tự động. Có trích dẫn chưa chắc đã đúng ngữ cảnh.
Đầu ra: Hồ sơ nghiên cứu đã xác thực, mỗi con số đều ghi kèm đường dẫn gốc, năm công bố và phạm vi mẫu khảo sát.
Bảng so sánh các gói Perplexity và tiêu chí chọn
Theo biểu phí công bố năm 2025 của Perplexity AI Help Center, bảng so sánh các gói Perplexity chia hệ thống thành bốn cấp độ chính gồm gói Free (miễn phí), gói Pro (20 USD mỗi tháng), gói Max (200 USD mỗi tháng) cho cá nhân và gói Enterprise Pro (từ 40 USD mỗi người mỗi tháng) cho tổ chức. Quyết định chọn gói cần dựa trên cường độ dùng Deep Research và ngưỡng bảo mật tài liệu nội bộ.
Khác biệt giữa gói Free, Pro, Max và Enterprise
Sự chênh lệch giữa bốn gói dịch vụ không chỉ nằm ở số lượt tìm kiếm nâng cao mỗi ngày mà còn ở quyền truy cập mô hình suy luận, tính năng Model Council, Perplexity Computer và cam kết bảo mật dữ liệu. Bảng dưới đây đối chiếu chi tiết các gói để chủ doanh nghiệp cân đối ngân sách đầu tư.
| Gói và mức giá | Năng lực mô hình và hạn mức | Điều kiện phù hợp thực tế |
|---|---|---|
| Free (0 USD) | Tìm kiếm cơ bản không giới hạn, giới hạn số lượt Pro Search và Deep Research mỗi ngày | Cá nhân mới làm quen công cụ hoặc chỉ tra cứu thông tin công khai tần suất thấp |
| Pro (20 USD/tháng) | Mở rộng Pro Search, Deep Research, tải tệp vào Spaces và chọn GPT, Claude, Gemini | Nhân sự nội dung, SEO hoặc nhóm marketing nhỏ cần nghiên cứu nguồn hàng ngày |
| Max (200 USD/tháng) | Hạn mức cao nhất cho mô hình suy luận, mở khóa Model Council và Perplexity Computer | Chuyên gia phân tích dữ liệu cường độ cao cần đối chiếu từ 2 đến 8 mô hình cùng lúc |
| Enterprise Pro (40 USD) | Giá theo mỗi người/tháng, kiểm toán bảo mật SOC 2, đăng nhập một lần (SSO), không lấy dữ liệu học | Doanh nghiệp cần tải báo cáo nội bộ lên Spaces và quản lý phân quyền tập trung |
Lưu ý khi đọc bảng giá: mức phí đóng theo năm của gói Pro (200 USD/năm), gói Max (khoảng 167 USD/tháng) và gói Enterprise Pro (400 USD/người/năm) được ghi nhận theo biểu phí năm 2025 trên Perplexity AI Help Center và Perplexity Enterprise. Hạn mức truy vấn trong ngày có thể thay đổi theo tải hệ thống và mô hình suy luận được chọn.
Tiêu chí chọn gói theo quy mô đội nhóm marketing
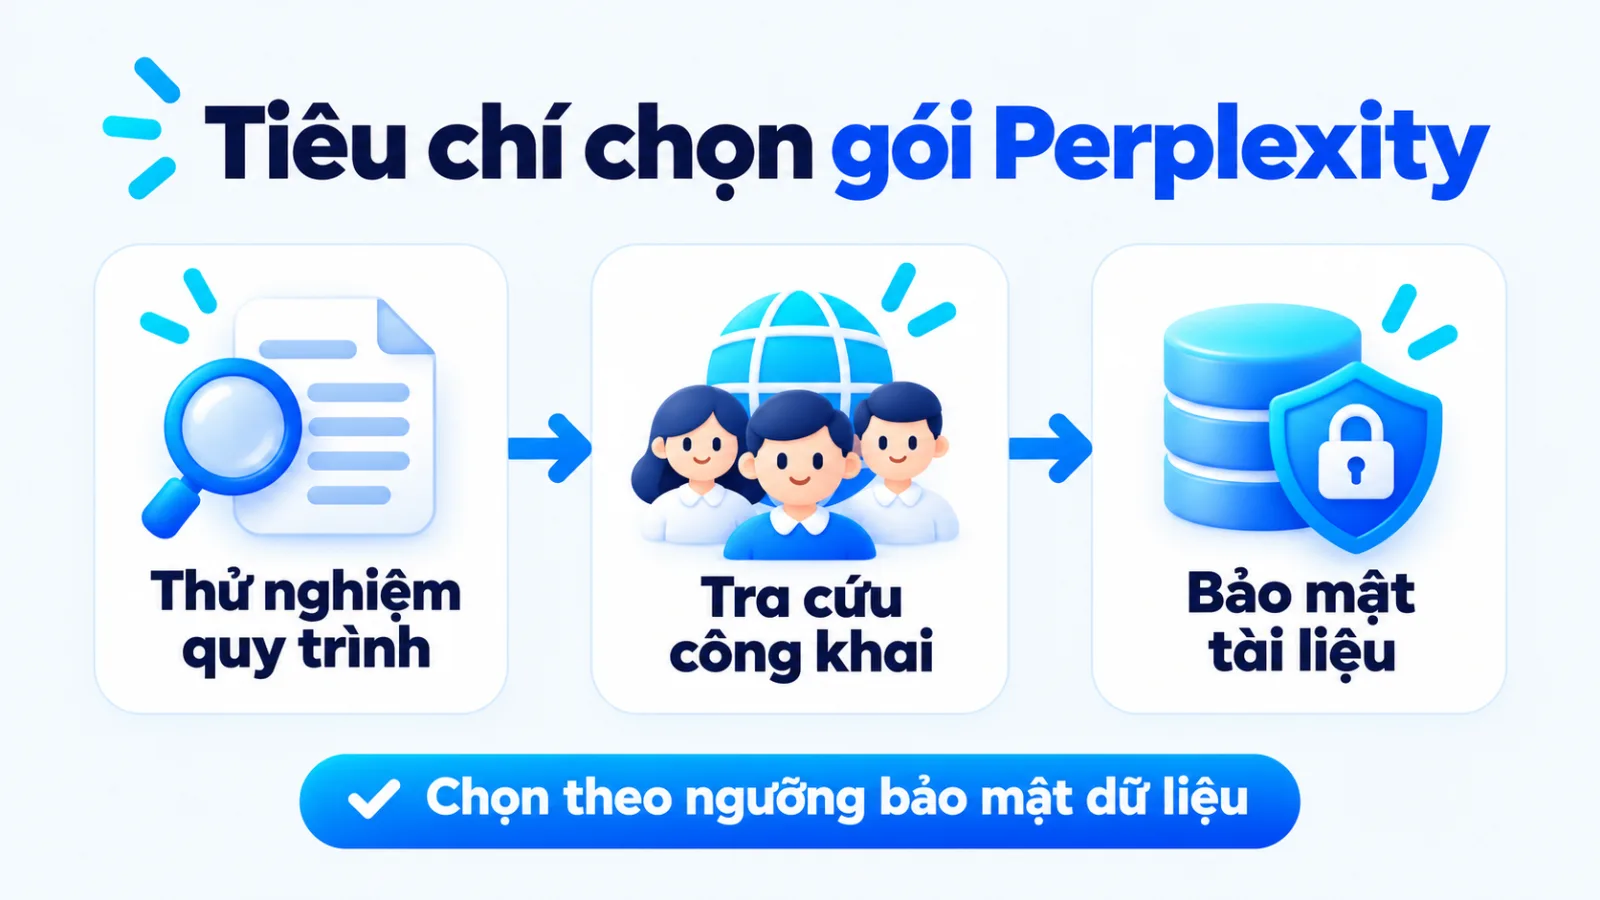
Với hầu hết doanh nghiệp vừa và nhỏ tại Việt Nam có đội ngũ marketing từ 3 đến 5 nhân sự, việc mua tài khoản trả phí cho toàn bộ thành viên ngay từ tháng đầu thường gây lãng phí ngân sách. Thay vào đó, ba tiêu chí thực tế giúp người phụ trách chọn đúng cấu hình thuê bao theo từng giai đoạn phát triển gồm:
- Giai đoạn thử nghiệm quy trình (0 USD): Dùng gói Free trong 2 tuần đầu để nhân sự rèn thói quen viết câu lệnh khóa phạm vi nguồn và kiểm tra liên kết gốc trước khi chi tiền.
- Giai đoạn vận hành nhóm nhỏ (20 đến 40 USD/tháng): Mua 1 đến 2 tài khoản Perplexity Pro cho người phụ trách kế hoạch và trưởng nhóm nội dung khi toàn bộ dữ liệu tải lên đều là thông tin công khai hoặc đã ẩn danh.
- Giai đoạn tích hợp dữ liệu công ty (từ 40 USD/người/tháng): Chuyển sang gói Enterprise Pro khi quy trình làm việc bắt buộc tải tài liệu dự án, dữ liệu kinh doanh nội bộ và cần kiểm soát nhật ký truy cập của nhân viên.
Tôi luôn khuyên các chủ doanh nghiệp tách riêng ngân sách công cụ tra cứu khỏi ngân sách công cụ sáng tạo. Trước khi duyệt mua thêm gói Max hay Enterprise, bạn hãy ghép công cụ này vào bài toán thiết kế luồng công việc AI tổng thể của phòng để đảm bảo mỗi tài khoản mở ra đều gắn với một đầu ra được nghiệm thu rõ ràng.
Hiểu Perplexity AI là gì để tránh lỗi trích dẫn
Khi chưa hiểu trọn vẹn Perplexity AI là gì ở góc độ giới hạn kỹ thuật, người dùng rất dễ mắc hai sai lầm nghiêm trọng: tin tuyệt đối vào mọi con số có gắn ký hiệu trích dẫn và đưa dữ liệu mật của doanh nghiệp lên các gói cá nhân hoặc trình duyệt tự động. Cả hai lỗi này đều bắt nguồn từ việc đánh đồng giao diện chuyên nghiệp với độ an toàn tuyệt đối.
Ảo giác trích dẫn khi link đúng nhưng tóm tắt sai
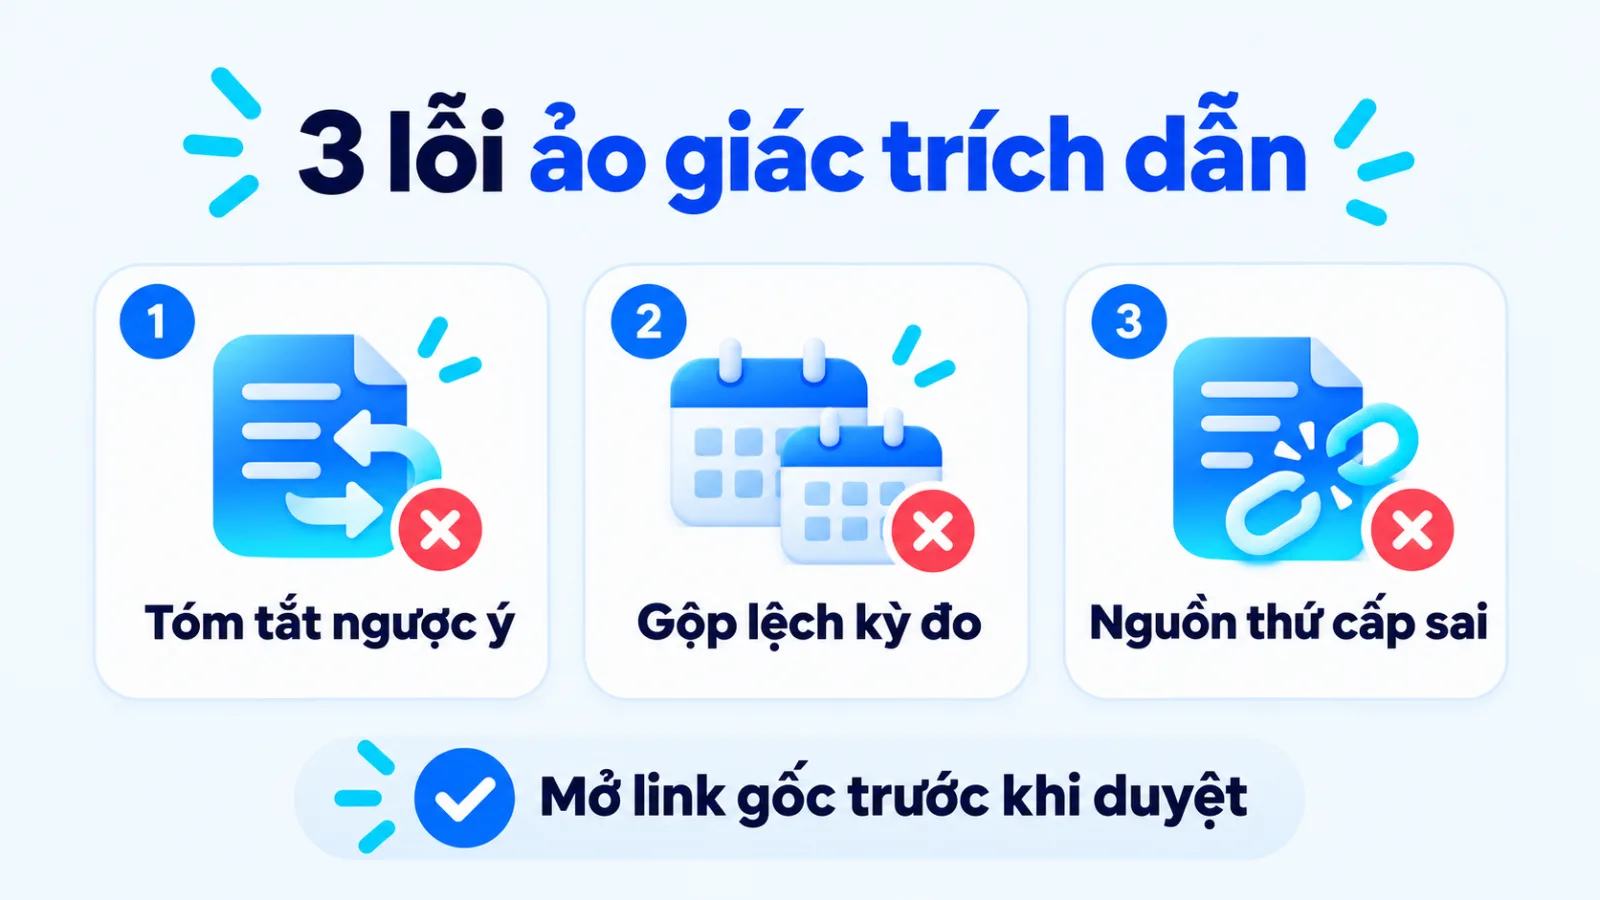
Nhiều nhân sự nghĩ rằng chỉ các khung trò chuyện không có nguồn mới bịa thông tin, còn công cụ có đính kèm liên kết [1], [2] thì luôn chính xác. Thực tế, cơ chế RAG chỉ giúp mô hình bám sát văn bản tìm được trên web chứ không miễn nhiễm với hiện tượng ảo giác AI trong quá trình tóm tắt và ghép nối dữ liệu.
Ba dạng sai lệch phổ biến khi máy tổng hợp nguồn gồm: đường dẫn có thật nhưng câu tóm tắt suy diễn ngược điều kiện bài gốc; mô hình gộp số liệu của hai kỳ đo khác nhau trên cùng một trang thành nhận định chung; hoặc công cụ trích dẫn từ trang thứ cấp vốn đã chép sai báo cáo gốc. Nếu người duyệt chỉ nhìn ký hiệu nguồn mà không bấm kiểm tra, sai số sẽ đi thẳng vào kế hoạch.
Phân loại dữ liệu cấm nhập vào Comet và Computer
Rủi ro thứ hai nằm ở quyền riêng tư dữ liệu. Theo chính sách trên trang Perplexity Enterprise năm 2025, chỉ gói doanh nghiệp mới cam kết mặc định không dùng câu lệnh và tệp tải lên để huấn luyện AI, còn gói cá nhân có thể lưu dữ liệu tương tác nếu chưa tắt trong cài đặt. Khi dùng thêm trình duyệt Comet hoặc Perplexity Computer, đội ngũ bắt buộc tuân thủ bảng phân loại ba nhóm dữ liệu dưới đây.
| Nhóm dữ liệu | Quyền dùng trên Perplexity | Biện pháp kiểm soát bắt buộc |
|---|---|---|
| Dữ liệu công khai | Được phép dùng trên mọi gói (Free, Pro, Max) và trình duyệt Comet | Kiểm chứng chéo liên kết gốc để loại bỏ nguồn thứ cấp kém độ tin cậy |
| Tài liệu nghiệp vụ nội bộ | Chỉ tải lên Spaces khi đã ẩn danh hoặc dùng trên gói Enterprise Pro | Xóa tên khách hàng, số hợp đồng và tắt tùy chọn lưu dữ liệu huấn luyện AI |
| Dữ liệu mật và định danh | Cấm tuyệt đối nhập vào khung chat hoặc mở trên trình duyệt AI Comet | Không đăng nhập tài khoản ngân hàng, hệ thống quản trị khách hàng (CRM) và báo cáo mật |
Giới hạn áp dụng của bảng phân loại trên: ngay cả khi doanh nghiệp đã trang bị gói Enterprise Pro đạt chuẩn kiểm toán bảo mật SOC 2 Type II, người quản lý vẫn phải ban hành quy chế cấm nhân sự dùng tính năng tác nhân tự động truy cập vào hệ thống chứa thông tin định danh cá nhân khi chưa có sự đồng ý hợp pháp của chủ thể dữ liệu.
Cách đo hiệu quả ứng dụng Perplexity trong đội ngũ
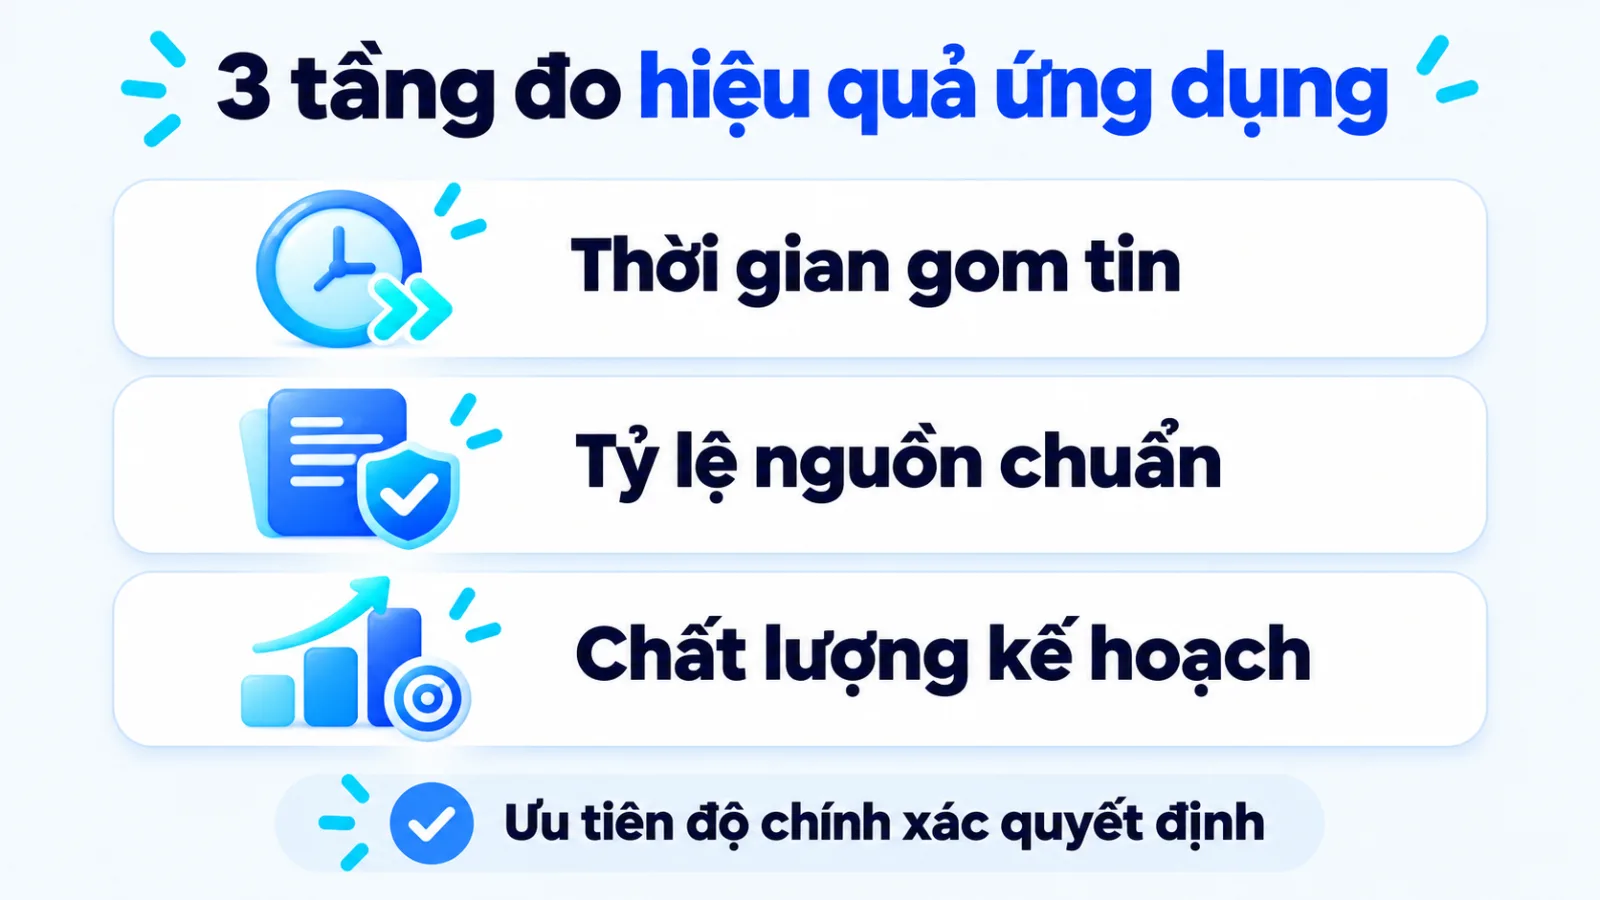
Hiệu quả triển khai Perplexity AI trong phòng marketing không đo bằng số lượng báo cáo dài mà công cụ xuất ra mỗi tuần. Người quản lý cần đánh giá lợi tức đầu tư qua ba tầng chỉ số liên kết chặt chẽ với nhau gồm: thời gian tiết kiệm ở khâu gom dữ liệu thô, tỷ lệ nguồn đạt chuẩn cấp một sau kiểm duyệt và chất lượng quyết định kinh doanh.
Bảng khung đo lường dưới đây giúp chủ doanh nghiệp vừa và nhỏ theo dõi hiệu quả thực tế sau 30 ngày cấp tài khoản cho nhân sự, tránh tình trạng mua công cụ theo phong trào nhưng chất lượng kế hoạch không thay đổi.
| Tầng đo lường | Cách tính và nguồn dữ liệu | Giới hạn khi đọc chỉ số |
|---|---|---|
| Tầng 1: Tốc độ tra cứu | So sánh số giờ lập hồ sơ nghiên cứu chủ đề trước và sau khi dùng công cụ | Tốc độ gom tin nhanh không đồng nghĩa với thông tin đã đúng và dùng được ngay |
| Tầng 2: Nguồn đạt chuẩn | Tỷ lệ liên kết trong báo cáo mở được, đúng nguồn cấp một và khớp ngữ cảnh gốc | Phụ thuộc trực tiếp vào kỷ luật đọc kiểm tra của người duyệt ở bước cuối |
| Tầng 3: Tác động đầu ra | Tỷ lệ dàn ý hoặc kế hoạch được duyệt ngay lần đầu và độ phủ thực thể của bài | Không quy kết trực tiếp doanh thu hay thứ hạng SEO chỉ nhờ riêng công cụ tra cứu |
Khi đọc bảng chỉ số trên, người phụ trách cần tách bạch rõ phạm vi đóng góp của công cụ. Perplexity AI chỉ giúp rút ngắn thời gian tìm kiếm bằng chứng và mở rộng góc nhìn ở khâu đầu vào; hiệu quả chuyển đổi khách hàng tiềm năng hay doanh thu cuối cùng vẫn phụ thuộc vào năng lực hoạch định chiến lược, chất lượng nội dung thực thi và sự phối hợp của toàn bộ hệ thống marketing.
Trước khi quyết định gia hạn thuê bao hàng tháng cho đội ngũ, bạn có thể áp dụng bốn câu hỏi kiểm tra nhanh sau đây để đánh giá mức độ trưởng thành của quy trình sử dụng trong phòng:
- Nhân sự có đính kèm đường dẫn gốc đã mở kiểm tra bên cạnh mỗi số liệu trong bản kế hoạch hay vẫn chép nguyên văn đoạn tóm tắt của máy?
- Các không gian làm việc trong Spaces đã được cài đặt chỉ dẫn lọc nguồn uy tín và làm sạch thông tin nhạy cảm trước khi tải tệp lên chưa?
- Tỷ lệ bài viết hoặc đề xuất kế hoạch phải trả về sửa lại do sai lệch dữ kiện thực tế có giảm xuống so với kỳ đo trước khi dùng công cụ không?
- Đội ngũ đã phân biệt rõ việc nào dùng Google Search, việc nào dùng Perplexity và việc nào chuyển sang ChatGPT để tránh lãng phí hạn mức truy vấn chưa?
Câu hỏi thường gặp về Perplexity AI
Làm sao yêu cầu Perplexity chỉ lọc nguồn uy tín tại Việt Nam?
Có hai cách thiết lập trực tiếp ngay trong phiên tra cứu để giới hạn nguồn tại Việt Nam. Bạn có thể chèn toán tử tên miền như site:gov.vn, site:chinhphu.vn hoặc chỉ định rõ tên cơ quan phát hành ngay trong câu lệnh. Nếu làm việc theo dự án dài hạn, bạn nên cài đặt danh sách tên miền ưu tiên cố định trong phần chỉ dẫn hệ thống của không gian Spaces để mọi truy vấn đều tự động tuân thủ khuôn này.
Vì sao số liệu Perplexity tóm tắt đôi khi lệch với báo cáo gốc?
Số liệu Perplexity tóm tắt đôi khi lệch với báo cáo gốc vì mô hình ngôn ngữ lớn gộp hai con số khác phạm vi đo trên cùng một trang hoặc lấy từ bài thứ cấp chép sai nguồn. Ký hiệu trích dẫn chỉ xác nhận trang đó có từ khóa liên quan chứ không bảo đảm giữ nguyên điều kiện mẫu khảo sát. Do đó, người duyệt bắt buộc phải mở liên kết gốc để đối chiếu đoạn chứa số liệu trước khi đưa vào kế hoạch.
Khi nào doanh nghiệp không nên dùng Perplexity AI?
Không nên dùng các gói Perplexity cá nhân khi tác vụ yêu cầu phân tích báo cáo tài chính mật, hợp đồng nội bộ chưa công bố hoặc danh sách khách hàng có thông tin định danh cá nhân (PII). Công cụ này cũng không phù hợp khi doanh nghiệp cần truy xuất số liệu kế toán nội bộ chính xác tuyệt đối mà không có nhân sự đối chiếu lại với cơ sở dữ liệu gốc của công ty.
Đội marketing 3 đến 5 người nên mua gói Pro hay Enterprise Pro?
Đội marketing 3 đến 5 người nên chọn gói theo mức độ nhạy cảm của dữ liệu tải lên hệ thống. Nếu nhóm chỉ tra cứu thông tin công khai và dùng tệp đã ẩn danh, việc mua 1 đến 2 tài khoản Perplexity Pro (20 USD/tháng theo biểu phí năm 2025) giúp tiết kiệm ngân sách. Ngược lại, khi bắt buộc tải tài liệu nội bộ lên Spaces và cần cam kết mặc định không lấy dữ liệu huấn luyện AI, doanh nghiệp phải chọn gói Enterprise Pro (từ 40 USD/người/tháng).
Tắt huấn luyện dữ liệu trên tài khoản Perplexity cá nhân ở đâu?
Người dùng gói Free, Pro hoặc Max có thể tắt quyền thu thập dữ liệu huấn luyện ngay trong phần Settings (Cài đặt tài khoản) bằng cách tìm mục Preferences hoặc Data Retention rồi gạt tắt tùy chọn AI Data Retention. Dù đã tắt tính năng này trên tài khoản cá nhân, đội ngũ vẫn nên xóa tên thương hiệu khách hàng và số liệu nhạy cảm trước khi tải tệp lên hệ thống.
Perplexity Spaces khác gì tính năng Projects của ChatGPT?
Perplexity Spaces khác Projects của ChatGPT ở trọng tâm kết hợp dữ liệu nội bộ với luồng tìm kiếm web thời gian thực có gắn trích dẫn từng câu. Trong khi Spaces phù hợp để đối chiếu tài liệu sản phẩm của công ty với báo cáo thị trường mới nhất trên internet, Projects của ChatGPT lại mạnh hơn về duy trì ngữ cảnh hội thoại dài hạn, giữ giọng văn thương hiệu và biên tập nội dung đa định dạng.
Kết luận
Giá trị cốt lõi của Perplexity AI nằm ở khả năng kết hợp tìm kiếm thời gian thực với trích dẫn nguồn trực diện để rút ngắn khâu gom dữ liệu thô, với điều kiện luôn có người duyệt kiểm chứng liên kết gốc. Ngay trong tuần này, bạn có thể lấy một chủ đề đang nghiên cứu, chạy thử chế độ Focus trên gói miễn phí và mở năm liên kết đầu tiên để đối chiếu độ khớp với tài liệu gốc.
Khi bài toán doanh nghiệp vượt khỏi việc tra cứu từng câu hỏi lẻ và cần tích hợp AI vào toàn bộ quy trình lập kế hoạch, sản xuất nội dung cùng hệ thống đo lường đồng bộ, bạn sẽ cần một khung phân quyền và kiểm soát chất lượng xuyên suốt. Hiện tại, khâu nghiên cứu thị trường của đội ngũ bạn đã có tiêu chuẩn kiểm chứng nguồn hay vẫn phụ thuộc vào thói quen riêng của từng nhân sự?


